 未来迷幻查看:370 回复:8 评论:17 创建时间:2023-07-29T11:44:15
用户:未来迷幻查看:370 回复:8 评论:17 创建时间:2023-07-29T11:44:15
当我们在爬取网页的时候难免会触发网站的反爬机制,有些小伙伴遇到这种情况就不知道该怎么做了,今天我来给大家讲解一种方法,赶紧码住~

这里我们那亚马逊举例 ⬇️
import requests

url = "https://www.amazon.cn"

r = requests.get(url=url)

print(r.text)
结果如下 ⬇️
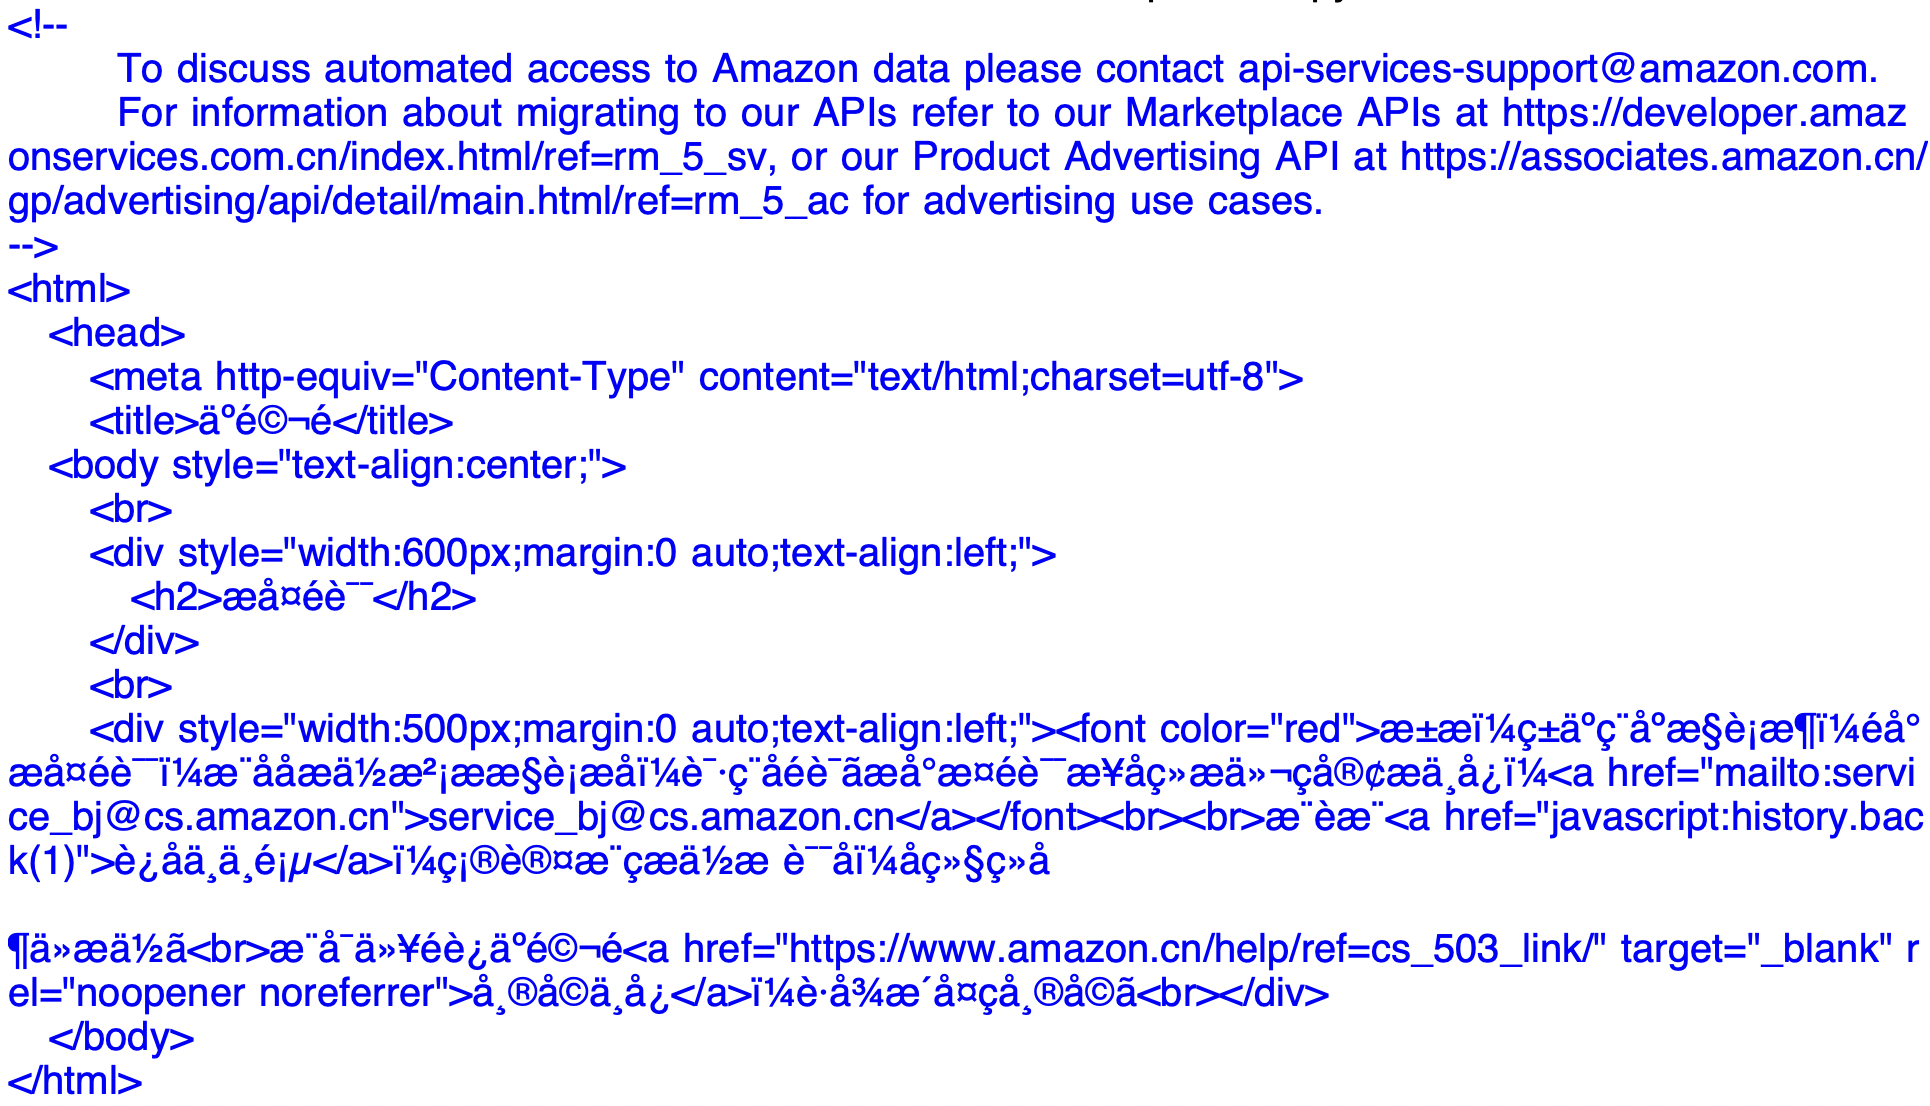
我们再转码看看 ⬇️
import requests

url = "https://www.amazon.cn"

r = requests.get(url=url)
r.encoding = "utf-8"

print(r.text)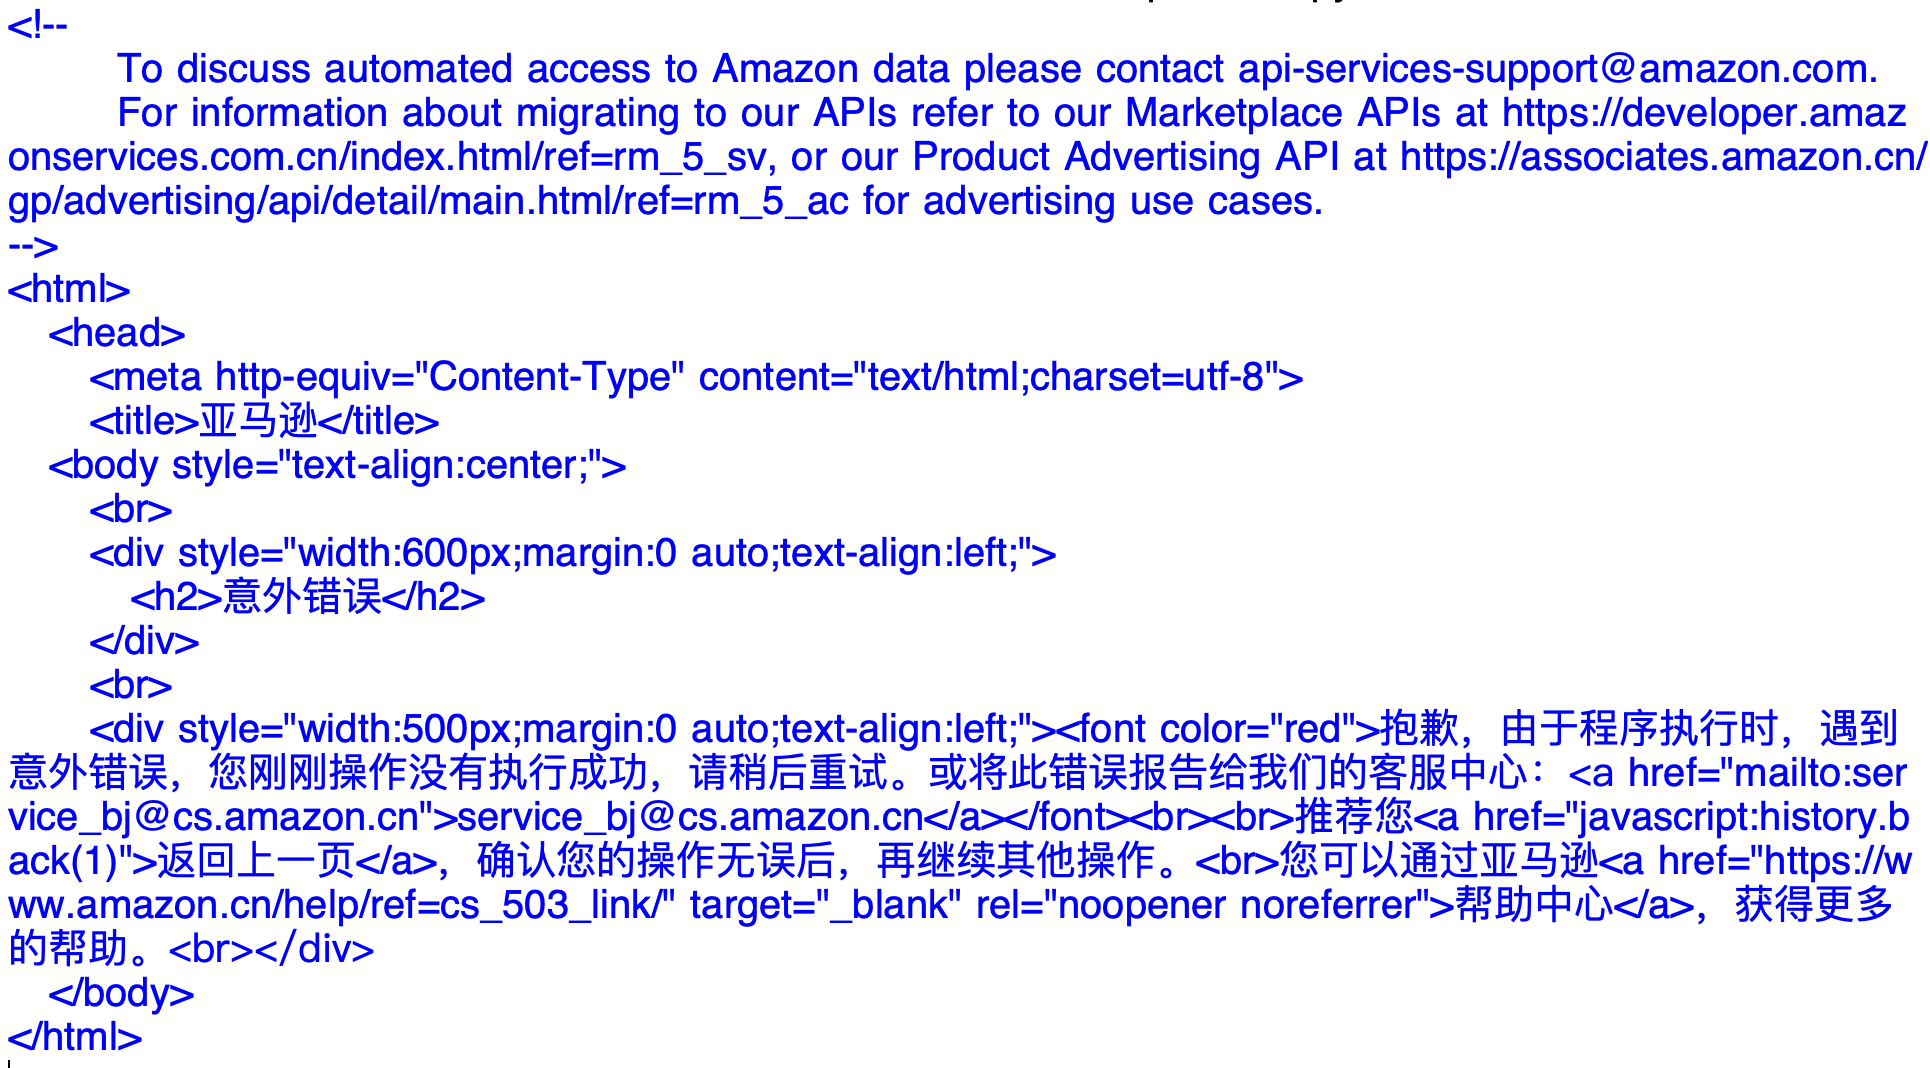
那么我们就可以看到它触发了反爬机制,亚马逊的反爬做的也是挺好的,所以就导致我们在访问他的主页的时候也会触发反爬机制,那么此时,我们有一种方法叫做模拟浏览器向服务器发起请求。干货来啦!看来我就给大家具体讲解一下,怎么模拟浏览器向服务器发起请求 ⬇️
我们用谷歌浏览器打开网页,右击网页空白处,点击检查。在新弹出的窗口中选择“Network”或“网络”。像这样 ⬇️
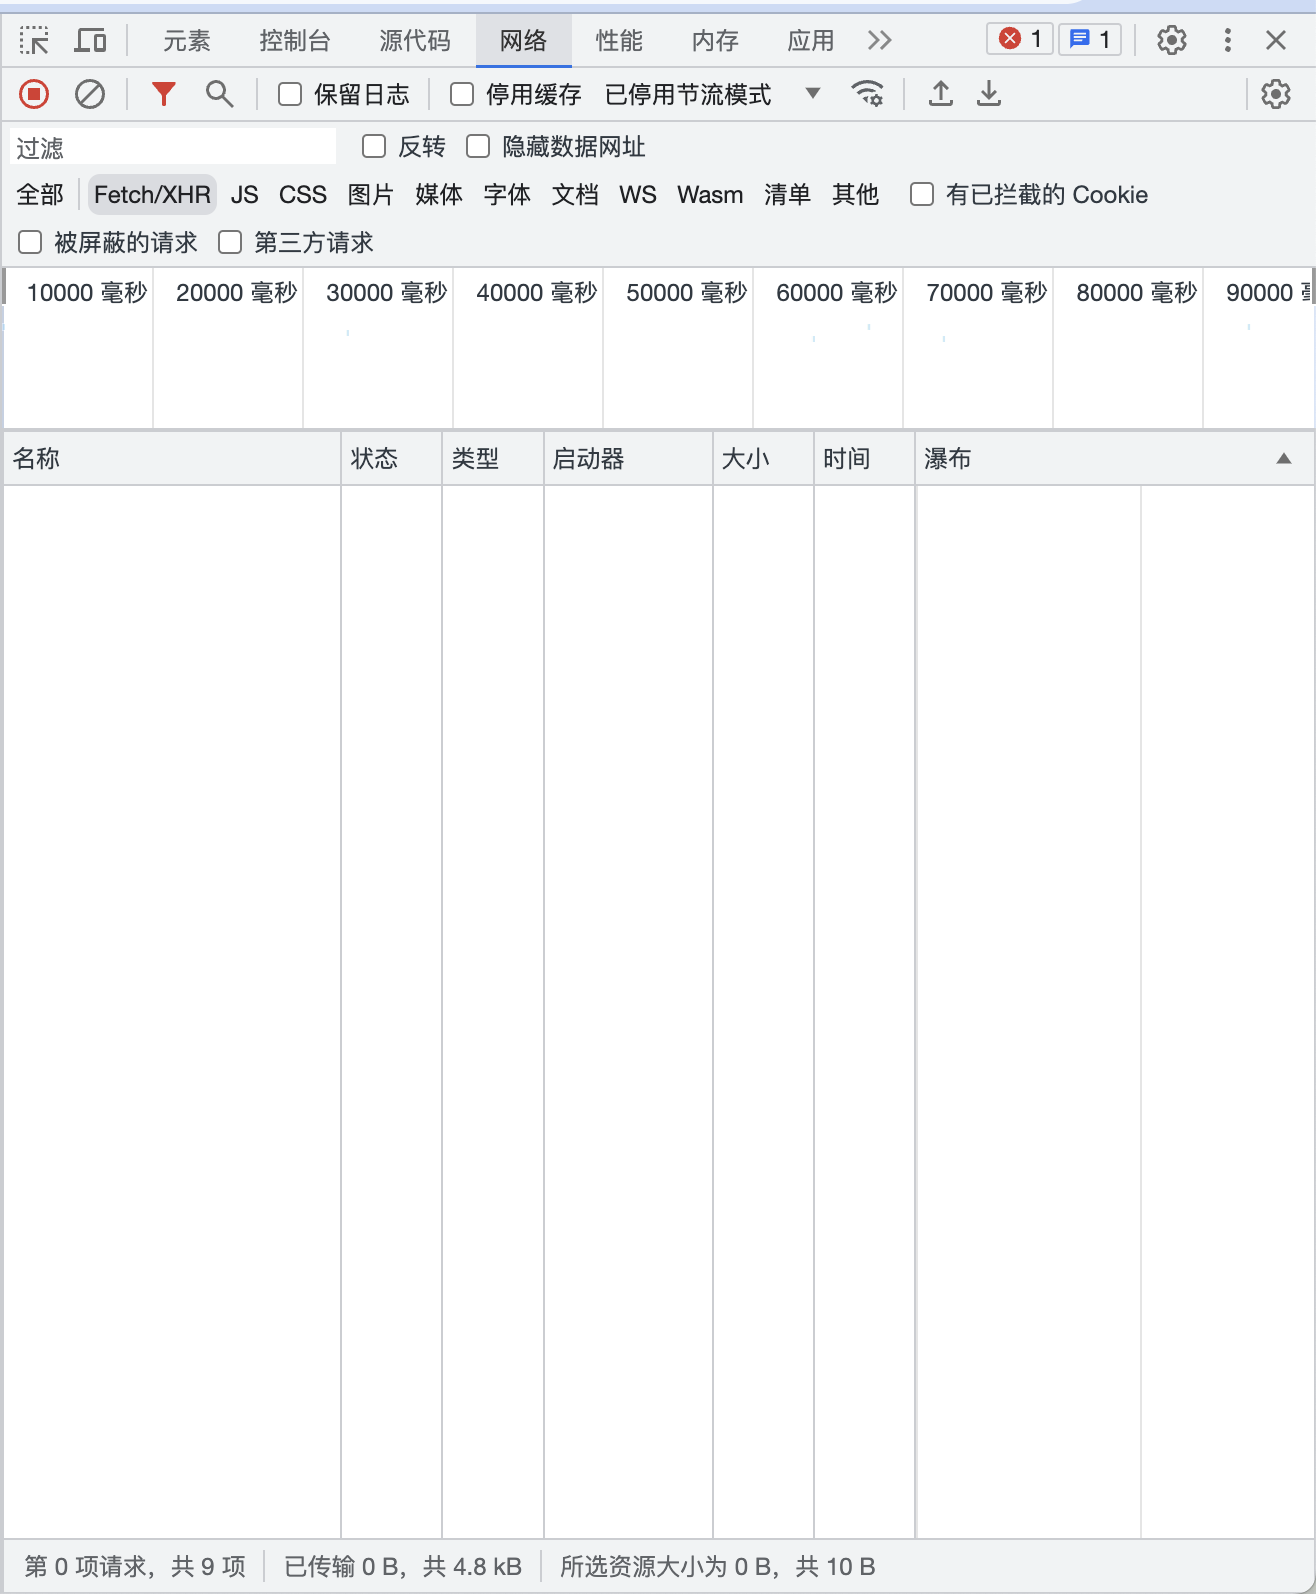
再点击下面的“XHR”或者“Fetch/XHR"选项,刷新页面,然后就会像这样 ⬇️
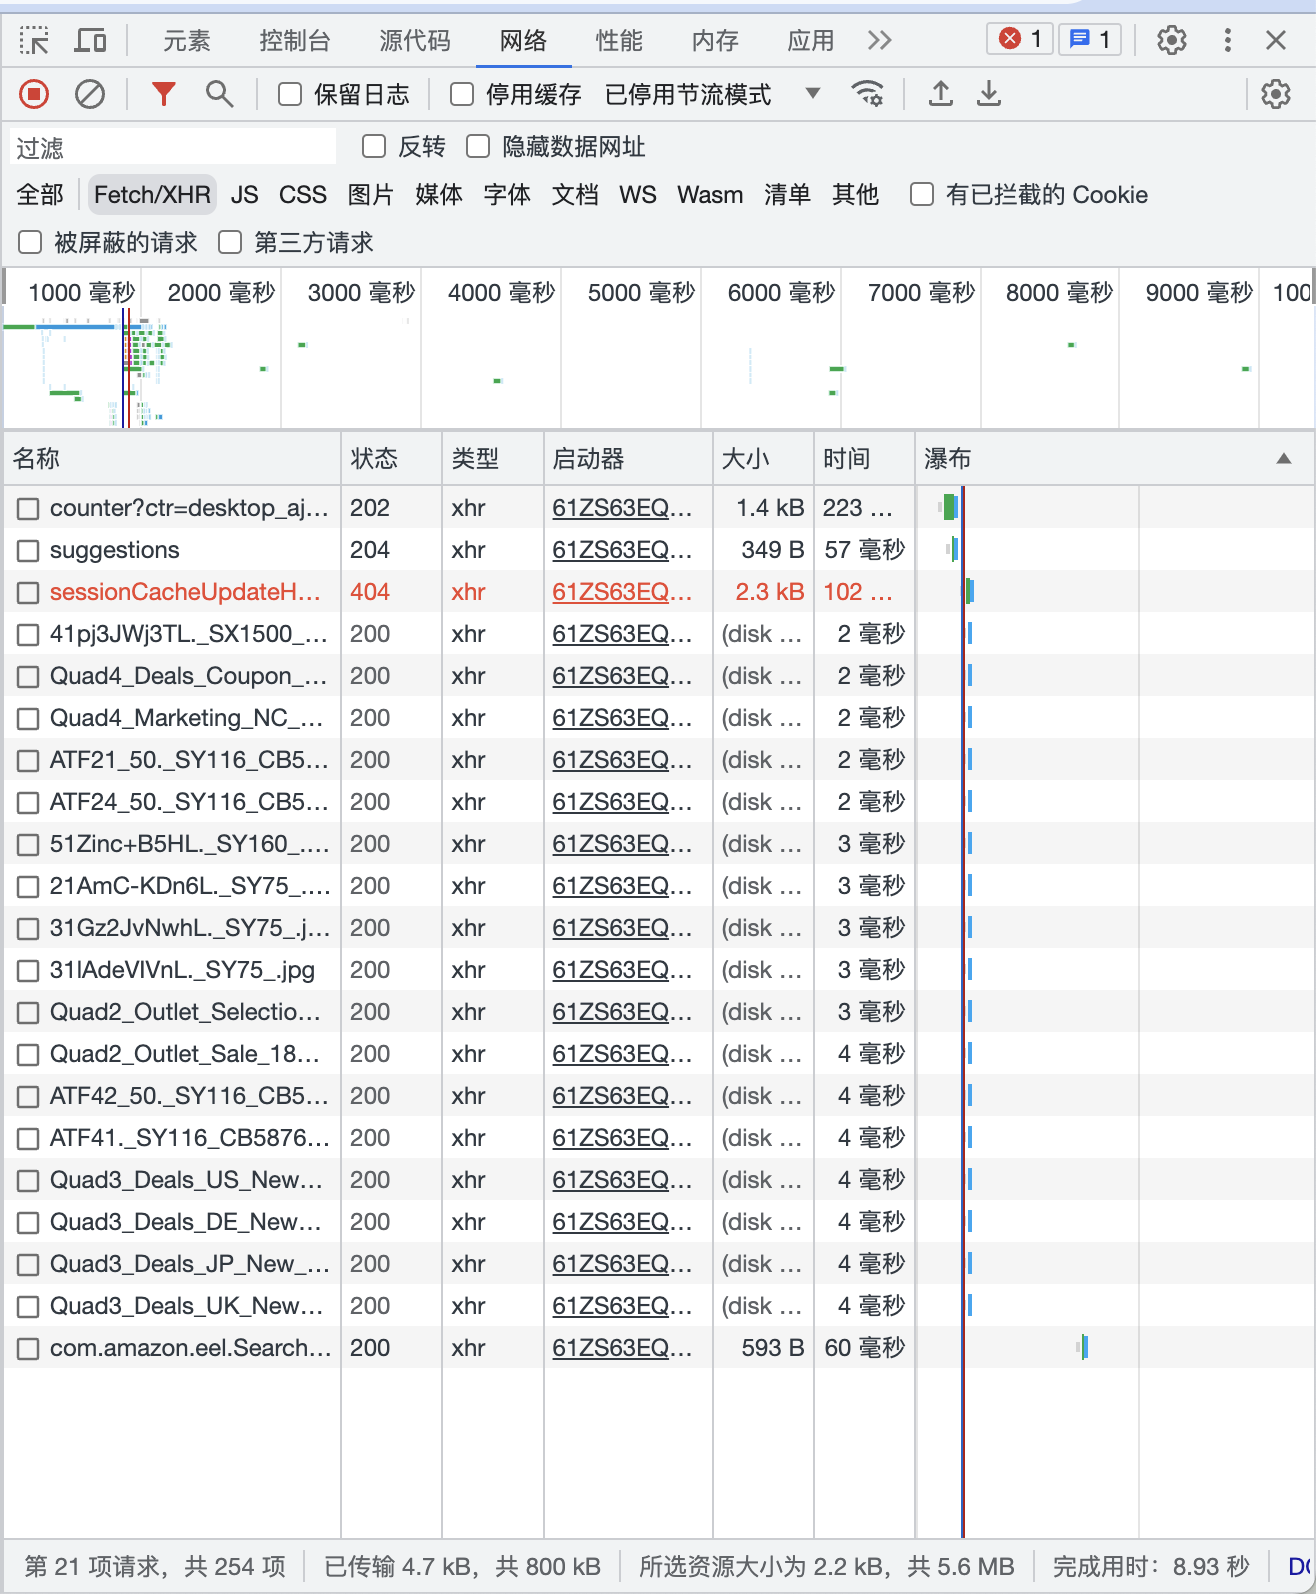
然后随机选择一个(红色的除外,红色的是加载错误的选项,但通常不会影响网页的刷新),点一下,选择“标头”或者"Headers",下滑找到"User-Agent"复制,像这样 ⬇️
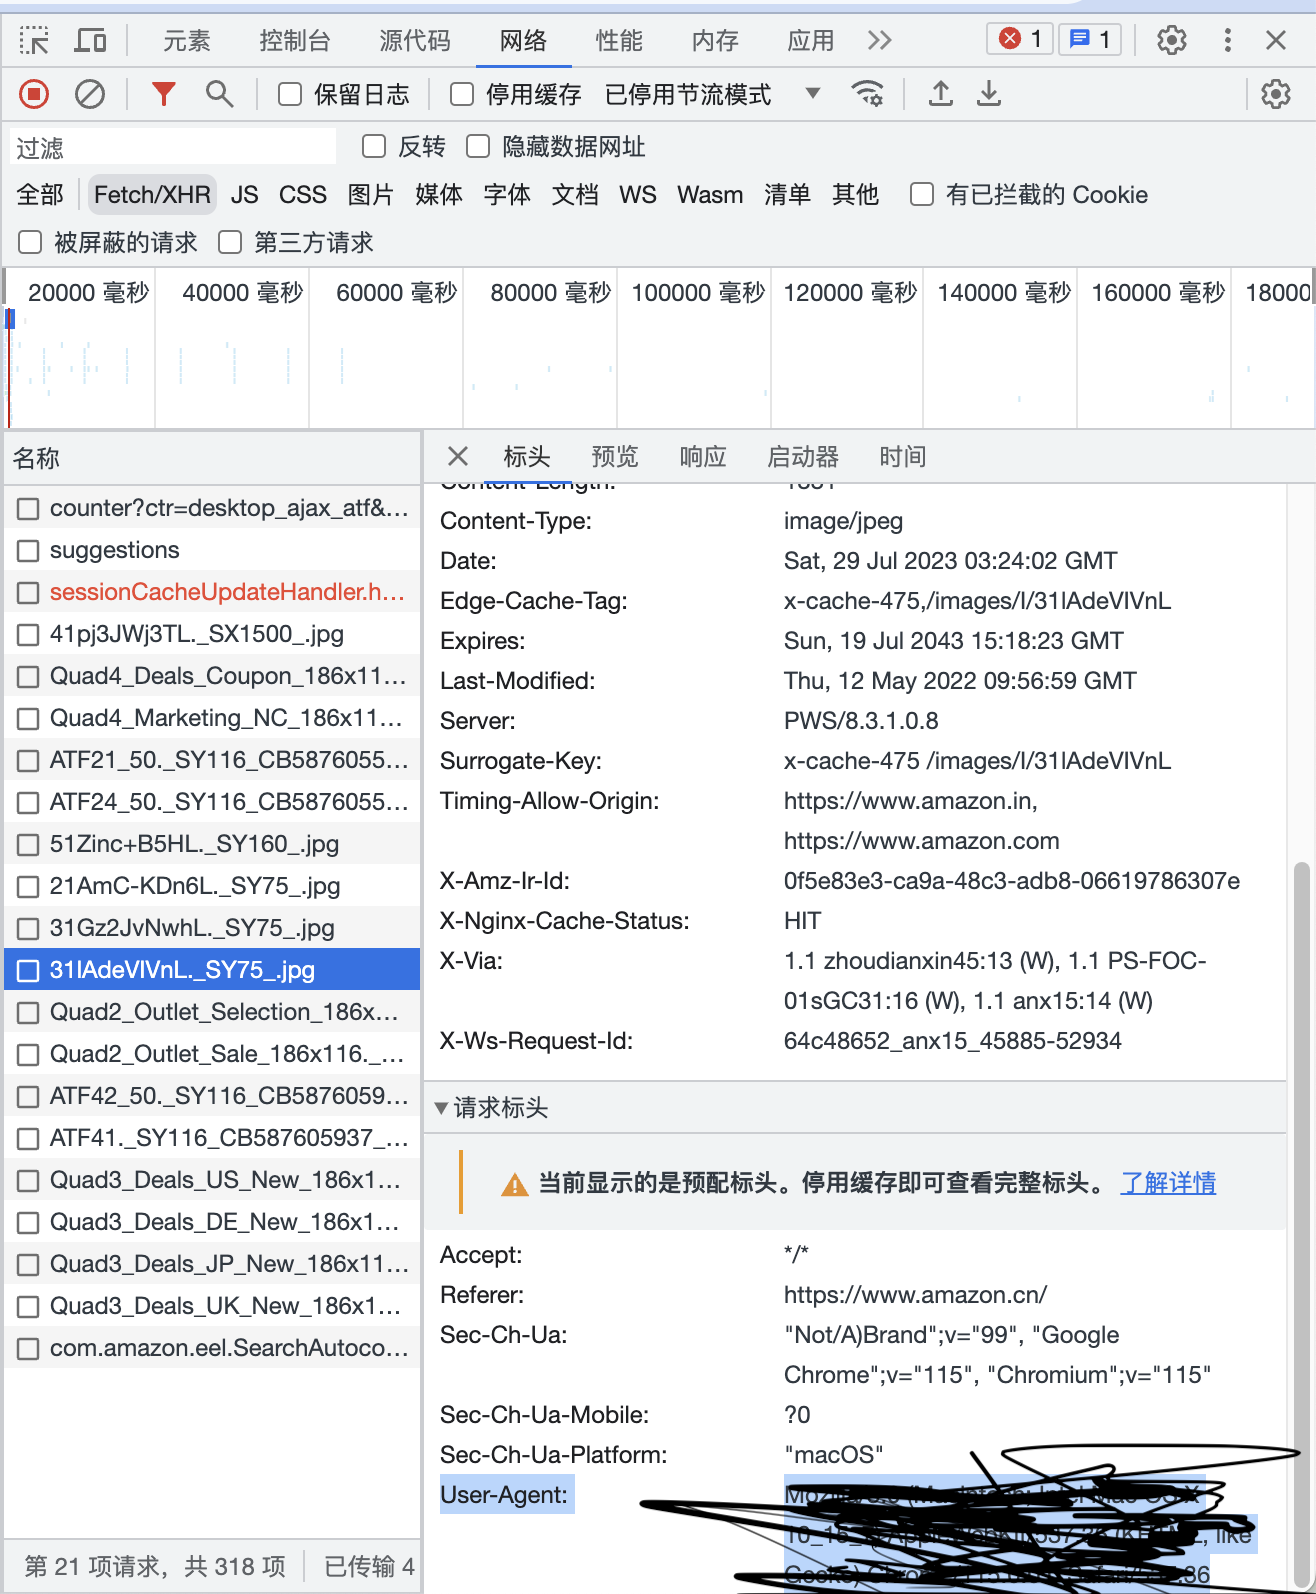
然后我们既可以返回代码,创建一个字典,像这样 ⬇️
import requests

url = "https://www.amazon.cn"

headers = {"User-Agent" : "这里输入“user-agent:”后面的内容,也就是我上一张图片中我用笔划掉的内容!注意!一定要用这种格式!"}

r = requests.get(url=url, headers=headers)
r.encoding = "utf-8"

print(r.text)
这里有一个易错区,就是字典的创建,举个例子:
这是我的user-agent:
User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KH喵L, like Gecko) Chrome/115.0.0.0 Safari/537.36 你就应该这么写:headers = {"User-Agent" : "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KH喵L, like Gecko) Chrome/115.0.0.0 Safari/537.36"}
这就是易错区的讲解,运行代码,你就可以得到:
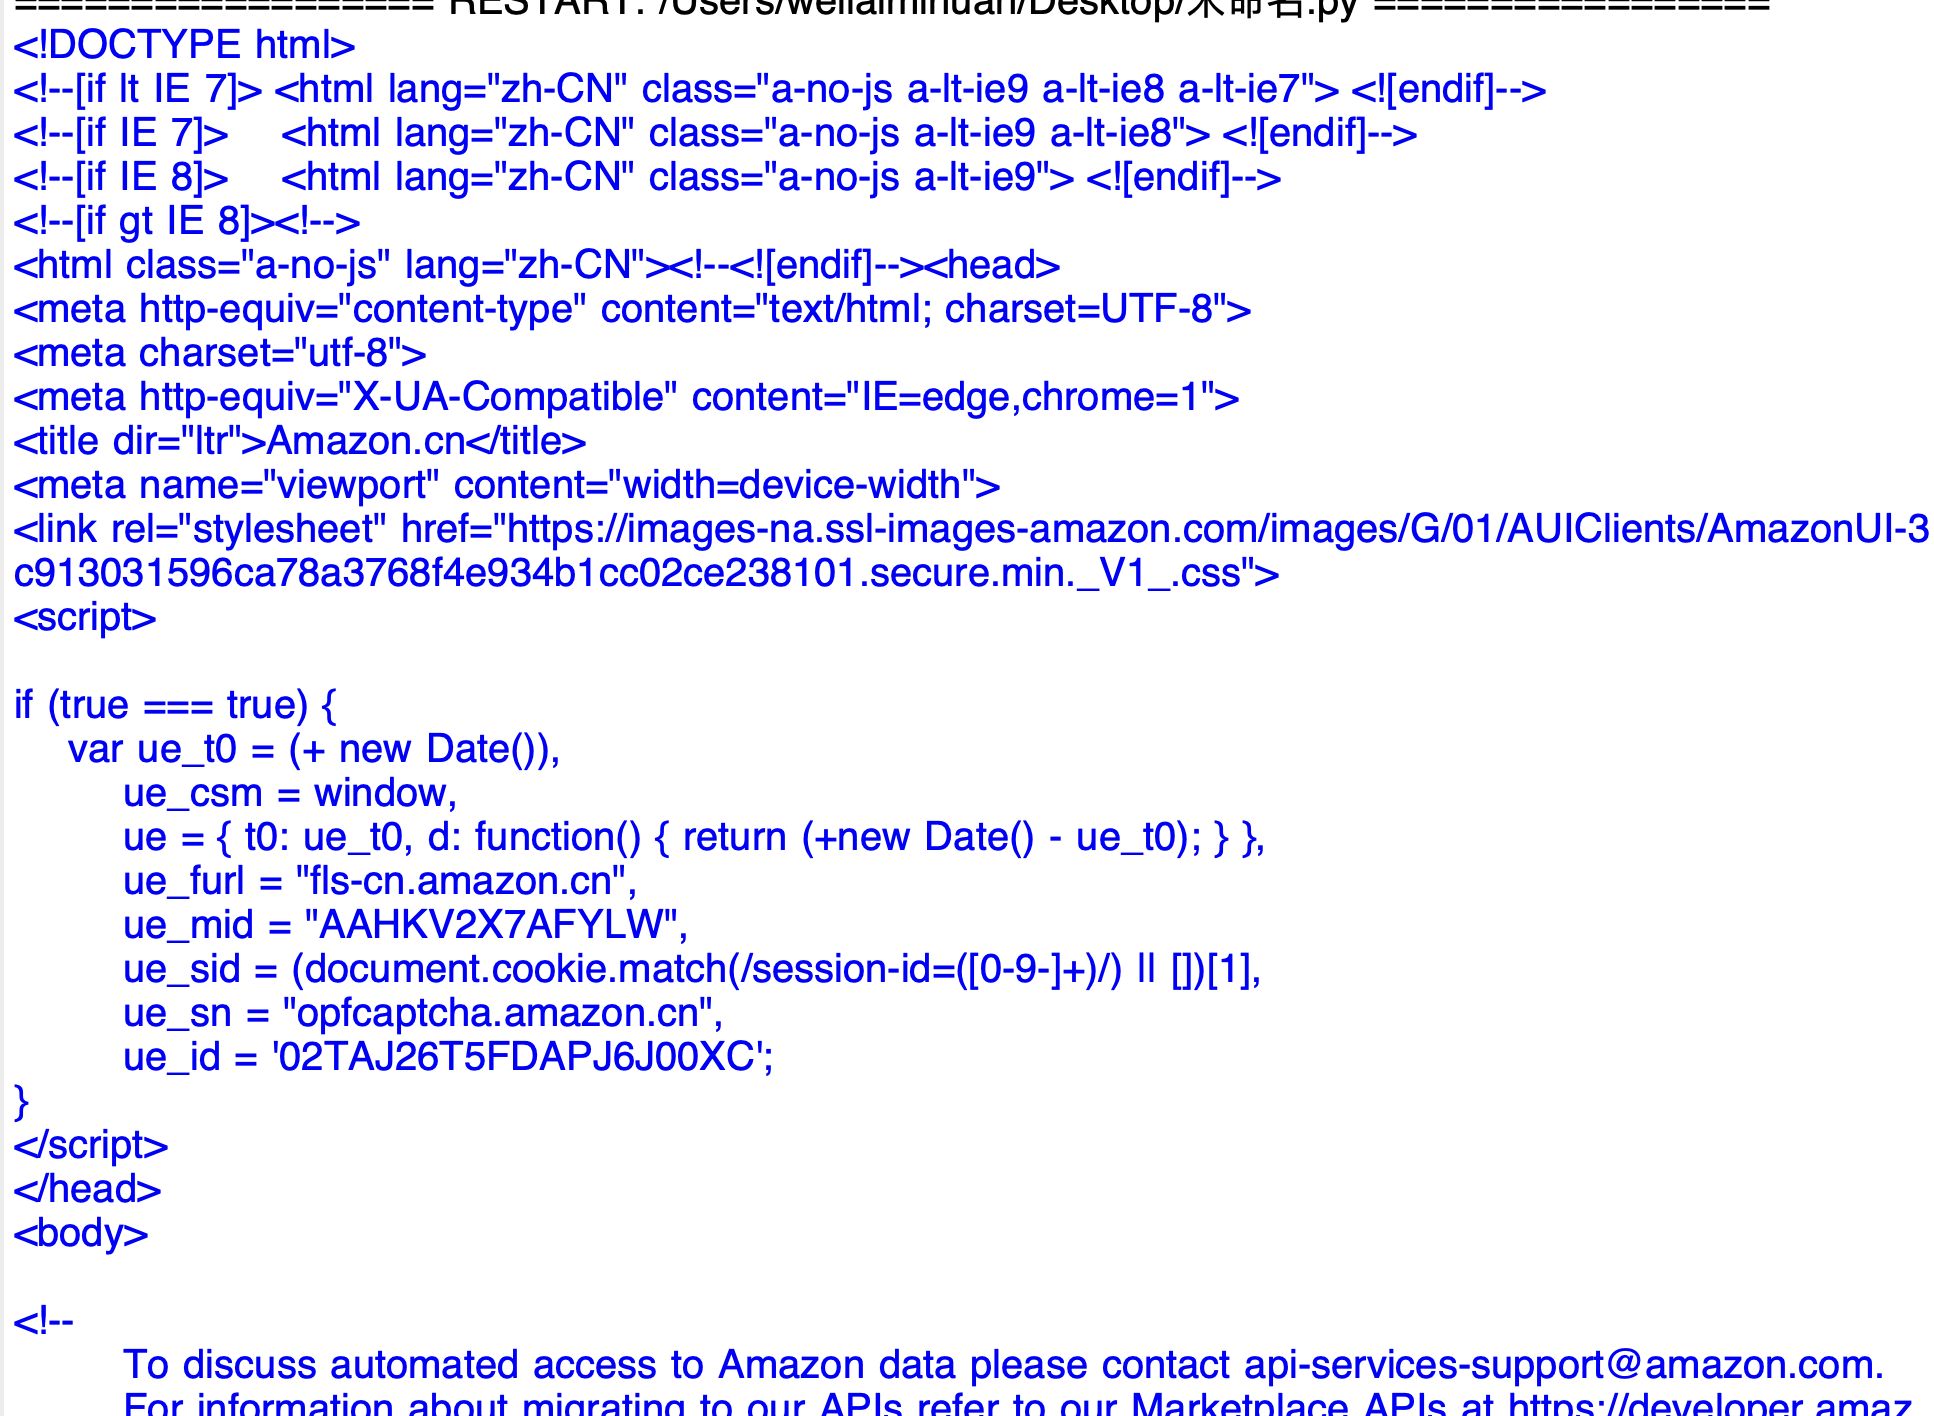
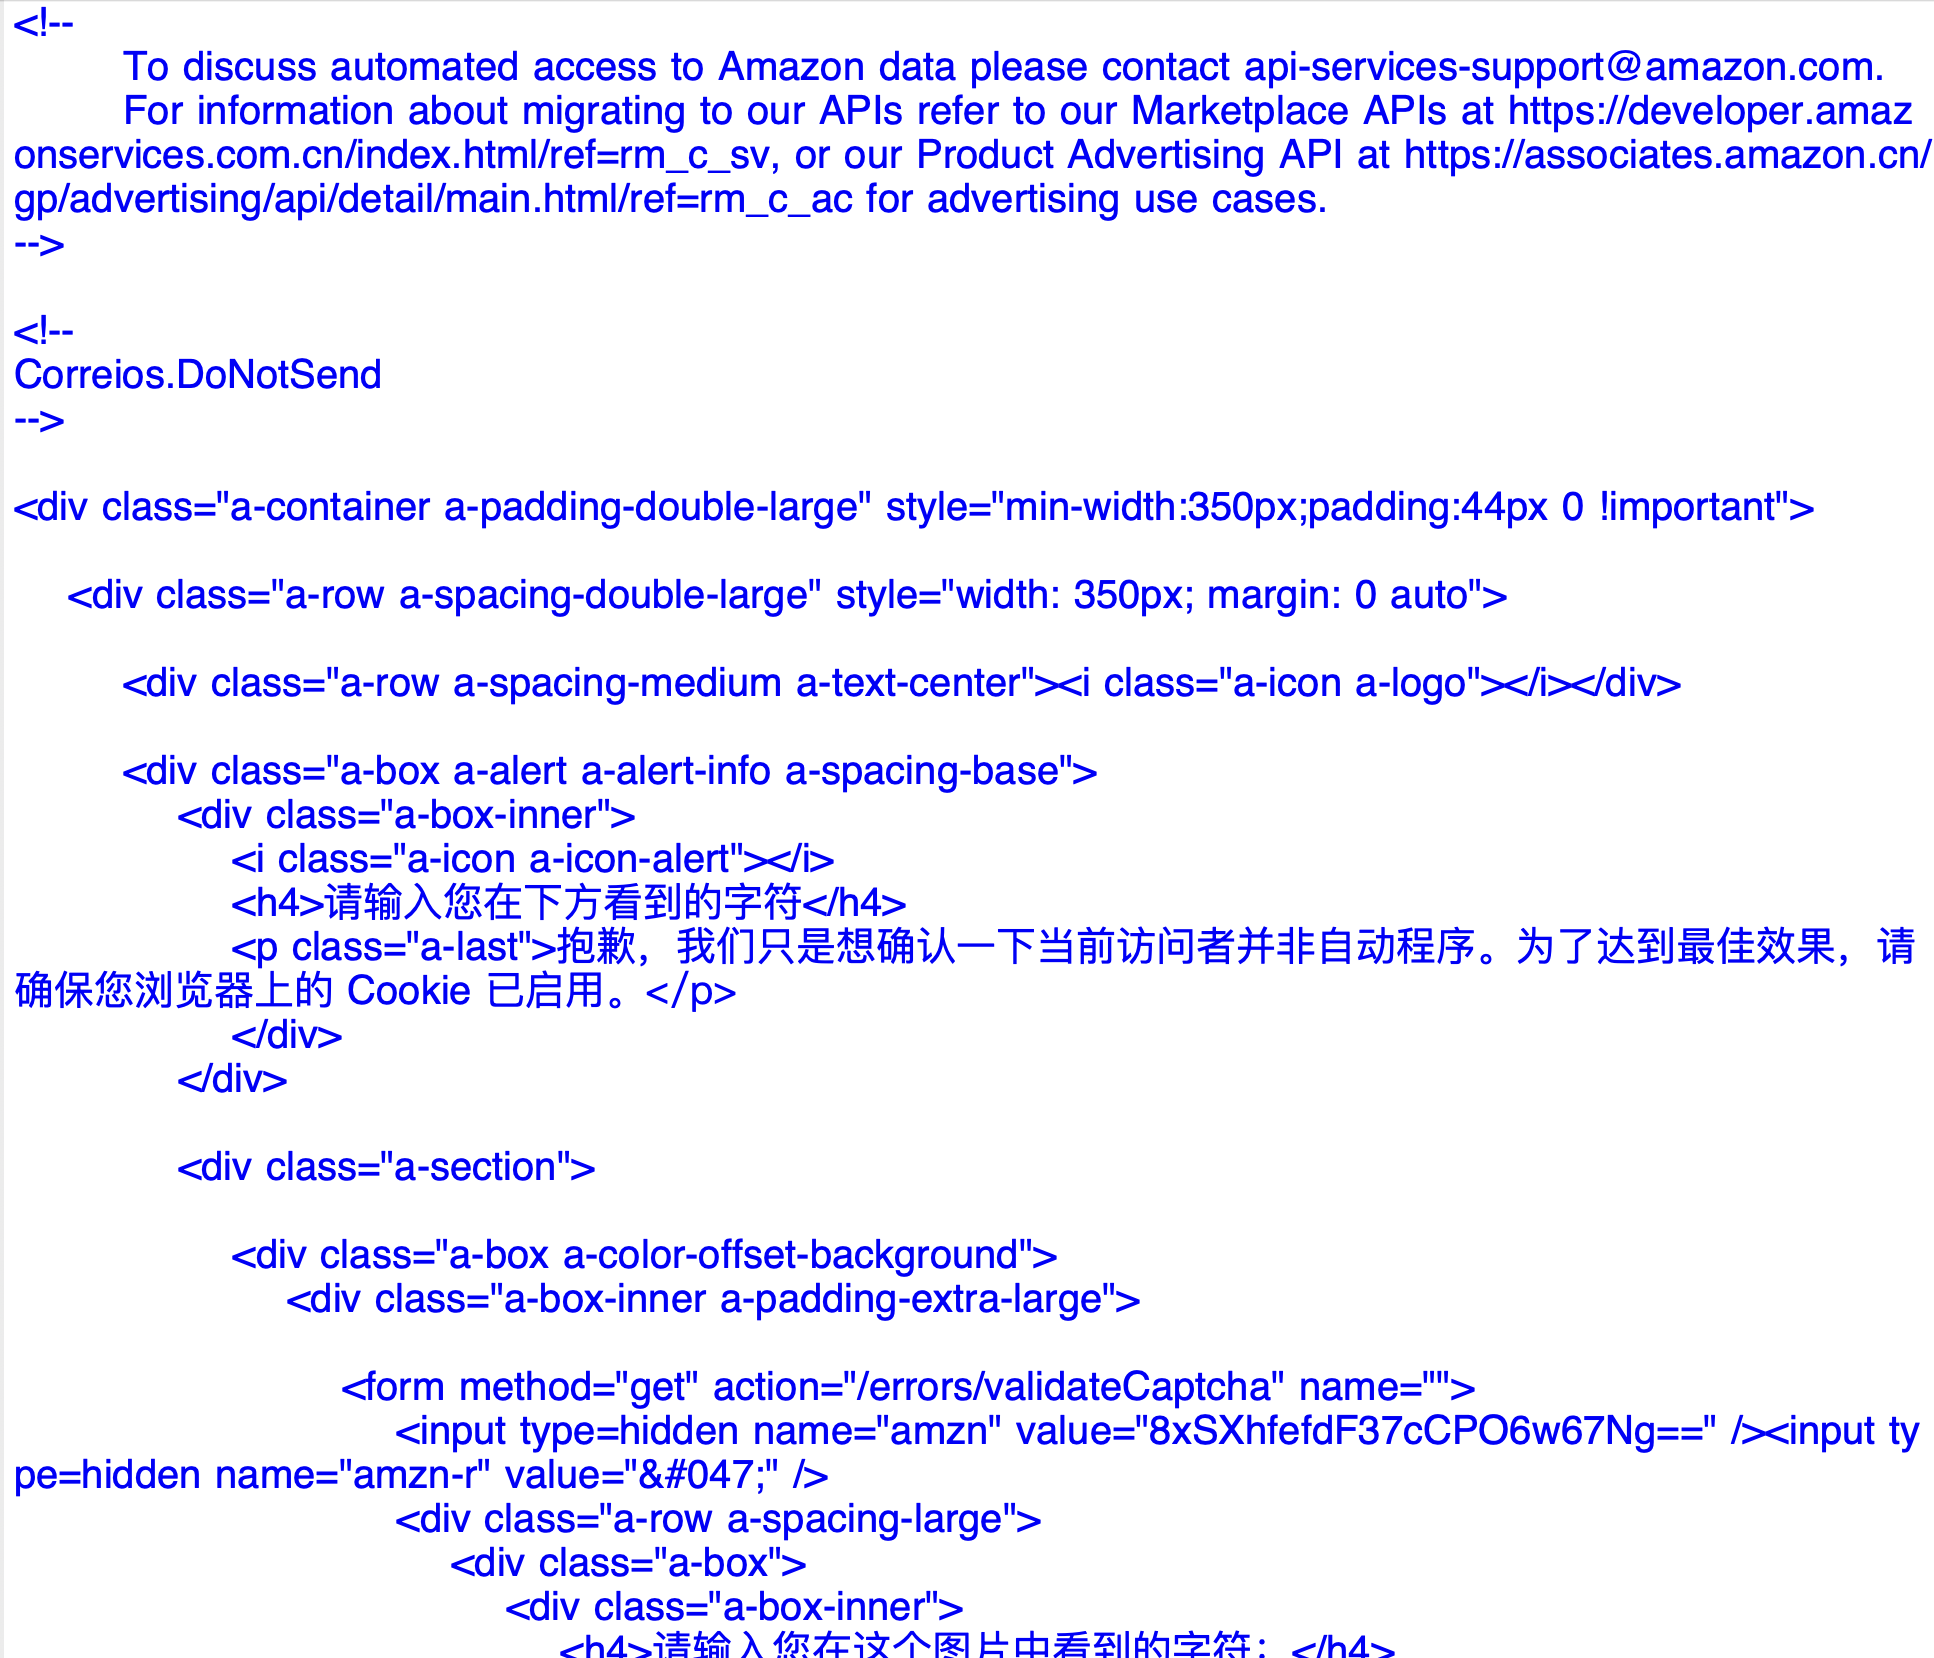
啊!反正就是很多就对了!不想在一个一个截屏了!

然后我们就成功啦!

哎!等等!爬虫学得好,牢饭少不了,慎用哦~
给个赞吧老铁们!

 依云大帝统治论坛
谢谢,但这是爬虫相当基础的东西,我觉得贴主既然这么用心,把精力放在这么简单的地方,不太合适吧?希望出一些复杂,困难的教程,然后再配很多图和文字,简单的东西不需要这么详细!=)
点赞1
评论
收到啦~ 感谢小宝的意见~ 我也会继续加油哒~~~
啊?你是老师吗???
啊?不是啊,我是学生啊!~
 不知道该叫啥的一只萌新
要防的话加user-agent没啥大意义,真要想爬还得pyppeteer或者selenium
点赞0
评论
现在很多网站对这种限制很严格,比如各种验证码,而且这种方式爬取只能爬到用户看见的内容,但是通过requests爬取可以爬到不给予用户展示的
但是防requests比防这个简单多了 只要加个动态加载你啥都爬不出来 对于真要严防的验证码…… 那基本属于全杀伤性的(包括正常用户) 参考steam的人机严重
而且我记得别的不说 爬猫站就还需要改content-type
哈哈哈哈哈,steam人机验证真实了🤣~~~~~
只要人识别不出来,那机器一定也识别不出爱(